Agent 都很能干,为什么工作交接还要从头开始?(技术解析与实践)
想象一个值班夜。周五晚上 9 点 40,群里跳进来一条消息:灰度环境的支付回调偶发重复入账。同一笔支付,被系统记了两次。
你从沙发上捞起笔记本,打开项目,新建一个 Codex 会话。白天那条对话太长,已经关了。新会话能读仓库,却不知道三件事:白天试过的分布式锁会拖慢对账;复现必须回放同一个幂等键;客户现场没有缓存集群,方案得在现有数据库条件下成立。
你花了 20 分钟补背景。Agent 随后又推荐了白天被否掉的锁方案。
灰度窗口快关了,你再找两个 Agent,一个审数据库风险,一个查旧客户端兼容性。结果一个把今晚不做的补偿任务算了进来,另一个审的不是当前代码版本。
三个 Agent 都在认真工作,你却又得把他们拉回来对齐。
代码保留了实现,日志保留了运行结果。那些决定“下一步该怎么做”的判断,仍散在旧对话里。工作分出去了,理解整件事的负担还在你身上。
这篇文章想讨论的,就是这个断点:当工作跨过会话、工具和参与者,怎样让已经完成的思考和验证被下一位接着使用?PowerContext 尝试把这件事做成一层独立的工作上下文。
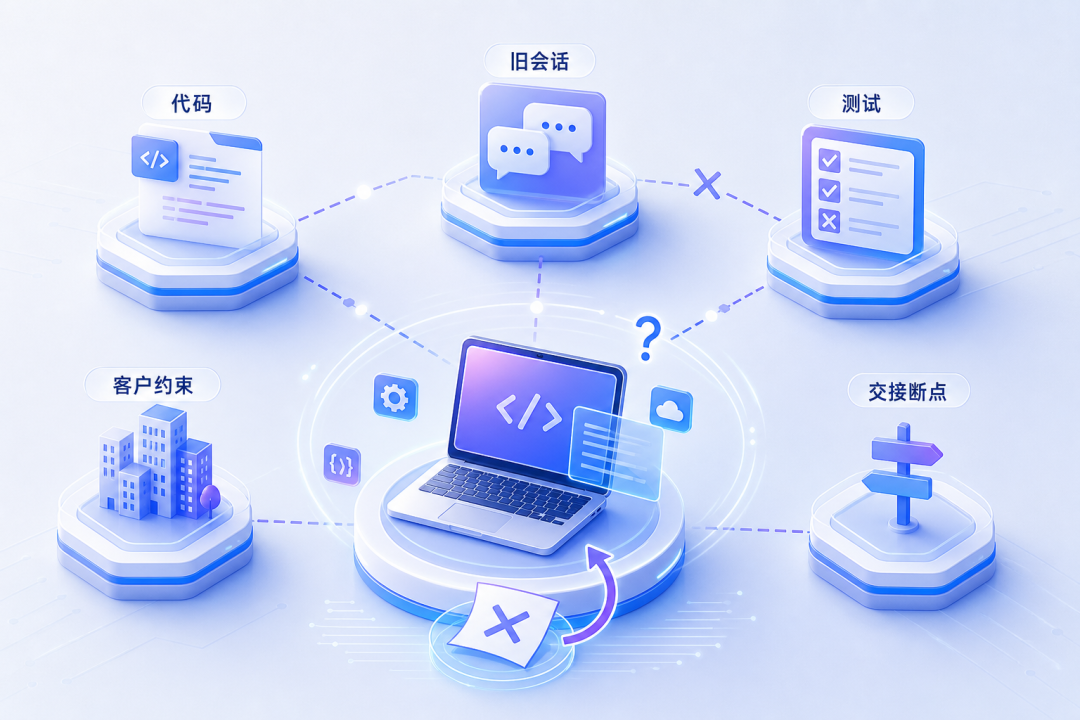
把值班场景放大,就能看到 AI Native 组织里的同类问题。
产品经理用一个 Agent 定功能范围,研发用另一个 Agent 改代码,销售再开一个做客户演示,布道师最后写快速入门。每个环节都提速了,但产品范围留在聊天里,客户约束躺在 CRM,失败原因埋在终端输出里。
写文档的人面对最新代码,依然不知道哪些能力已经验证、哪些还不能对外承诺。
2026 年的几项公开实践,也碰到了相似的边界。
1 月,组织背景成为 Agent 能力的一部分。
OpenAI 的内部数据 Agent 把表结构、人类标注、代码、组织知识、记忆和运行时状态放在一起使用。模型知道怎样写 SQL,还需要知道公司究竟怎样定义一个指标、哪些数据可以一起算.
2 月,状态开始跨越单次请求。
OpenAI 与 AWS 公布带状态的运行环境,面向跨步骤、工具、审批和系统状态的生产任务。工作进行到哪里、出错后怎样恢复,成为运行环境需要承担的职责。
3 月,跨会话的进度记录成为长任务的必要配套。
Anthropic 介绍了持续运行的科研工作方式,并回顾 Claude 跨约 2,000 个会话构建编译器的实践。科研案例专门维护进度文件,记录当前状态、验证结果、失败路线和原因,避免后续会话重走死路。
4 月,人的上下文切换成为瓶颈。
OpenAI 的 Symphony 团队观察到,工程师通常只能舒适地同时管理三到五个会话。团队由此把工作组织在任务和交付物周围,让人集中审核结果。这是团队实践中的观察,并非所有人的固定上限。
5 月,上下文开始被独立管理。
LangChain 推出 Context Hub,让上下文文件能够存储、版本化、协作和发布。Google Cloud 同期介绍长任务的检查点、恢复与人工审批机制。两者分别处理内容管理和执行连续性,也说明“把提示词写好”只是其中一个环节。
6 月,长任务与并行工作显现出规模。
OpenAI 的研究中,70.2% 的抽样个人用户提交过预计超过一小时人工工作量的任务;内部使用量处于第 99 百分位的用户,每天经常产生超过 60 小时的并行 Agent 运行时间。前者依赖模型对人工耗时的估算,后者是并行运行时长,都不能直接当作节省的工时。Microsoft 也在 Build 上推出连接人员、邮件、文档、会议和业务数据的上下文能力。
8 月,协作也暴露出自身的失败方式。
Anthropic 的多 Agent 实验观察到代码合并冲突、彼此隔离的工作方式,以及多个 Agent 趋同决策导致的集体错误。增加参与者,并不会自然得到可靠的团队协作。
这些实践分别处理组织知识、跨会话进度和任务调度。他们并不证明所有团队都需要同一种架构,但指出了一个共同问题:执行越来越便宜,协调和核验的成本开始显眼。
多开几个 Agent,可以增加执行能力。可这个结果属于哪个任务、基于哪版代码、下一位能不能直接用,仍然需要明确的记录和检查。
上下文问题容易被混成一件事:把历史存下来,下次再读。
但恢复一次运行、记住一条知识和接手一项工作,需要保存的内容不同。
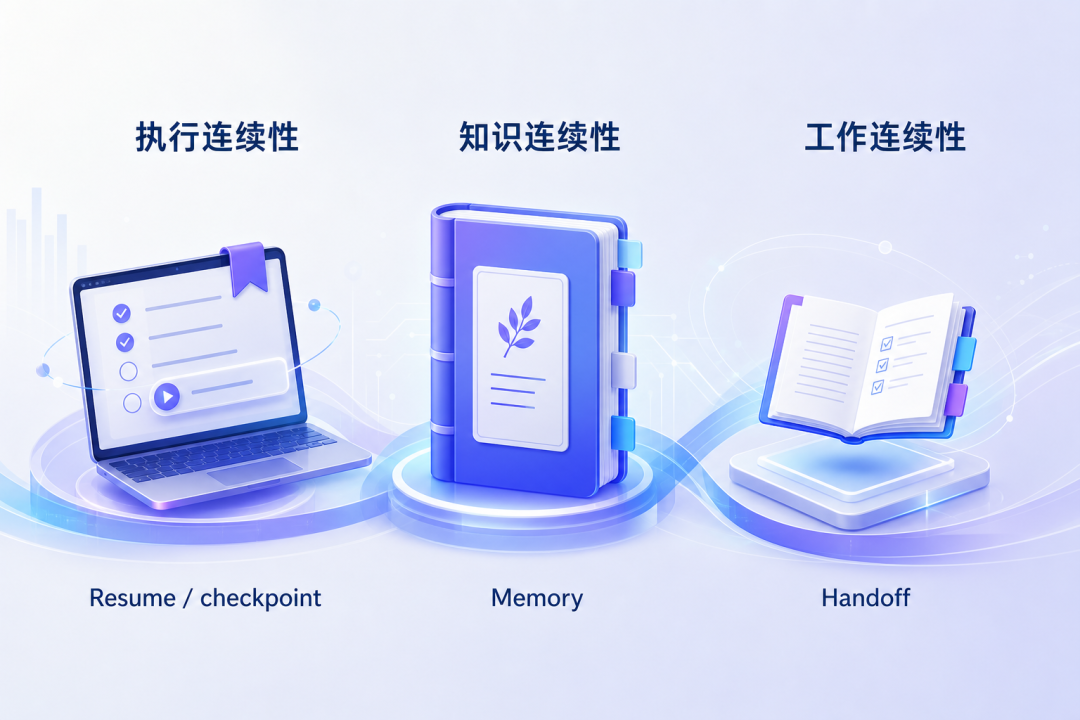
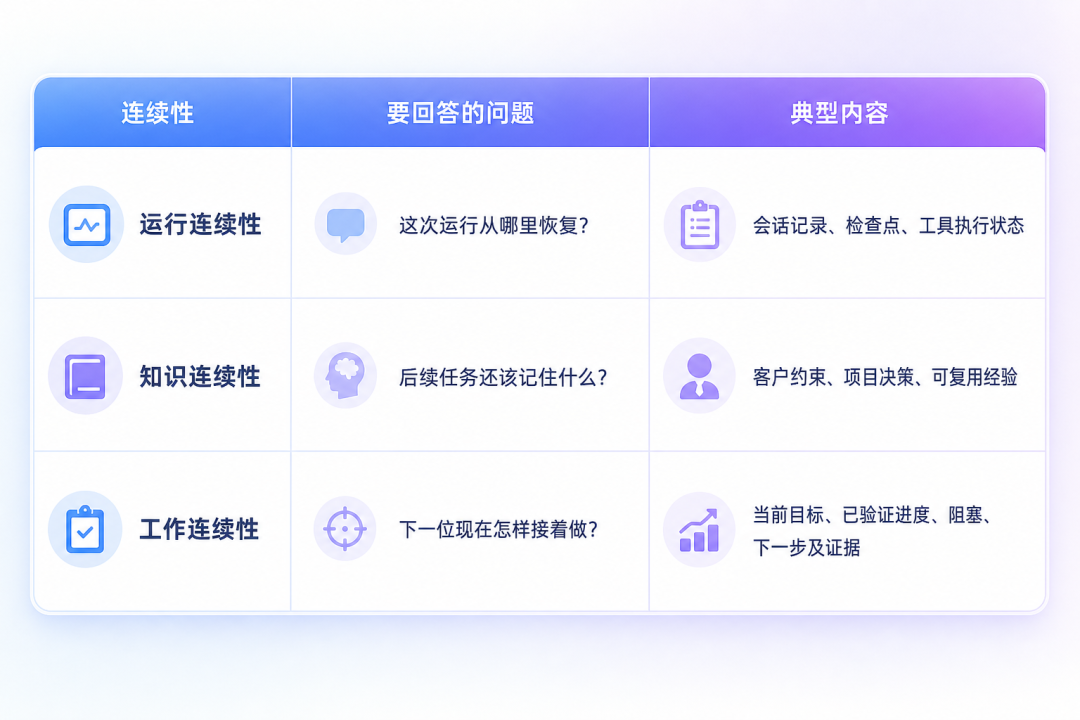
- 第一类通常由 Agent 所在的工具或运行环境负责,恢复范围取决于他的实现;
- 第二类适合进入长期记忆,也就是 Memory;
- 第三类需要一份面向接手者的工作交接,也就是 Handoff。
回到支付故障。
“这个客户没有缓存集群”可能是后续任务仍然有效的知识;“兼容性还没验证,今晚先别发布”则属于当前工作状态。
如果把两者都当作长期规则,临时安排会不断积累。如果只保存长期知识,下一位又不知道工作停在哪里。
Memory 回答以后还应该记住什么;Handoff 回答下一棒现在怎样接着做。
这也是我们把 PowerMem 演进为 PowerContext 的原因:在记忆之外,进一步处理未完成的工作如何继续。代码仓库、工单和可观测系统仍各司其职,PowerContext 负责连接其中值得继承的证据、判断和状态。
一份交接最容易漏掉的,往往是尚未完成的部分。
支付重复入账问题已定位,继续处理,看起来像一条进度,接手者却还得从头问起:怎么复现的?哪个方案不能用?代码改了吗?测试跑到了哪一步?
开头的场景,可以整理成这样一份交接:
目标      在灰度窗口内完成修复与验证;是否发布由人确认
范围      处理支付回调重复入账,补偿任务另行评估
已验证    使用同一个幂等键回放,可以复现问题
已放弃    白天的分布式锁方案:对账延迟超过客户可接受范围
环境约束  客户现场没有缓存集群,方案须适用于现有数据库
待核实    数据库改动风险、旧客户端兼容性
下一步    基于同一代码版本完成两项检查,汇总结果后申请灰度
证据      复现日志、环境说明、代码版本、测试命令及结果
待核实应该和已验证一样显眼。
测试通过也需要带上条件:验证的是哪版代码、什么环境、哪些用例。否则一句已通过,很容易在转交中变成全部没问题。
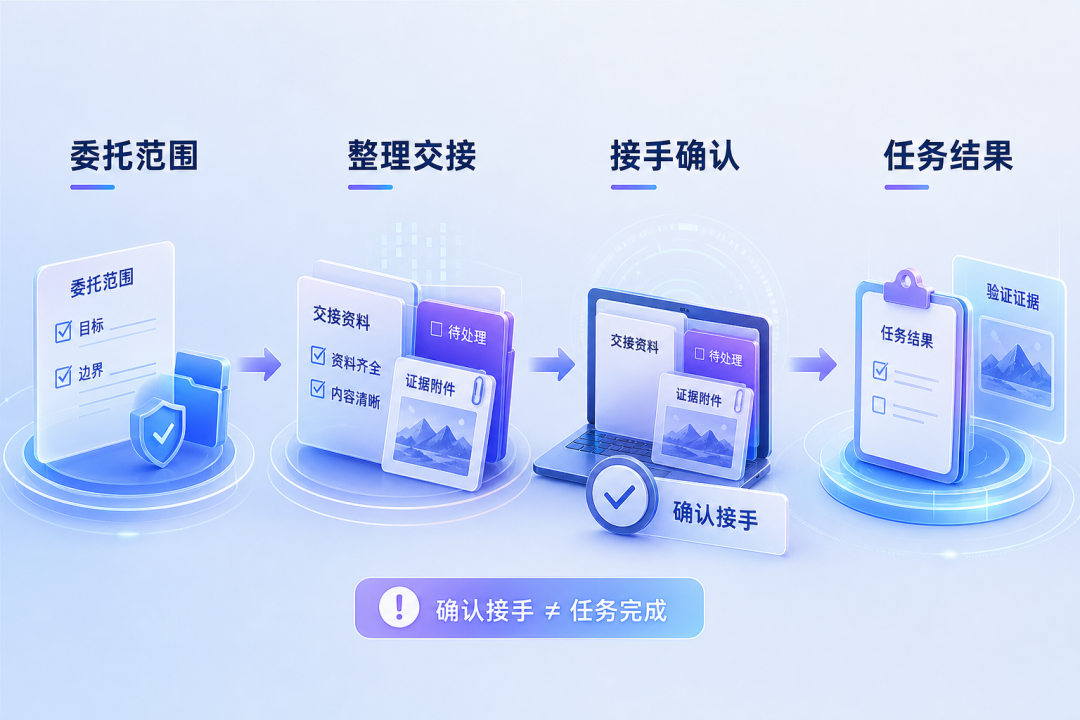
PowerContext 把这条交接链路分成几个可区分的状态:
- 先记录委托目标和完成边界,再准备并检查 Handoff;
- 需要保留里程碑时,提交为明确版本;
- 接收方核对当前状态、能力和授权,确认接手、请求澄清或拒绝;
- 最后记录实际结果。
注:交接工作流程(链接:https://github.com/oceanbase/powercontext/blob/powercontext-v1.0.0/docs/zh/docs/workflows/handoff-with-codex.md)
交接已经发出、有人接手、任务已经完成,是三件不同的事。分开记录,团队才能看出工作停在哪一步。
接手确认也不会增加权限。Agent 可以完成风险审查,但是否发布,仍要遵守当前任务的授权要求。
临时交接默认不等于长期项目知识。需要保留的工作里程碑可以提交,后续仍然有效的客户约束则可以单独进入 Memory。这样,今晚先这样做就不容易被误读成以后必须这样做。
能交接,还不够。一份过期或未经验证的交接,可能把错误传得更快。
群里一句猜测、客户提供的环境说明、实际执行的测试日志,证据地位并不相同。他们都可能相关,却不能一起被压成“已经确认”。
PowerContext 用 Source 保存输入证据及其来源,再将适合后续使用的内容整理为 Memory 或其他上下文制品。请求到来时,Server 按项目范围、相关性和字节预算组装上下文,并附上来源引用。这份按需准备的结果称为 PreparedContext。
这条链路有几个必要的边界。
首先,采集不等于确认。提示词可以被采集为 Source;配置服务端生成模型后,系统可以进一步提炼记忆。显式记录则走相应的写入流程。不能因为一句话被捕获,就把他当成已经验证的项目事实。
其次,更新要保留历史。客户环境变了,旧约束应该能够修订或停用,同时留下变更记录。接手者需要知道一个结论属于哪个 Scope、对应哪次修订、依据是什么。
注:Memory 与 Handoff 的边界(链接:https://github.com/oceanbase/powercontext/blob/powercontext-v1.0.0/docs/zh/docs/workflows/memory-and-handoff.md)
再次,召回内容仍是不可信历史。他可以帮助 Agent 找到排查起点,但不能覆盖当前用户请求、仓库规范和操作权限。“之前没部署缓存集群”值得核对,却不能代替对当前环境的检查。
上下文还必须有预算。
一次请求只应带入与下一步有关的材料,必要时再沿引用展开。自动召回失败时,集成应按其降级策略继续原工作,同时保留诊断信息;缺失的上下文不能假装已经成功注入。
可复用经验同样需要审核。
PowerContext 的 Experience 和托管 Skill 先形成候选,人工审核精确版本后,才生成不可变的制品修订。模型生成候选不会自行批准;Skill 获批后也不会自动安装或获得执行权限,仍需显式导出到使用他的工具。
注:Experience 与 Skill 生命周期(链接:https://github.com/oceanbase/powercontext/blob/powercontext-v1.0.0/docs/zh/docs/workflows/experience-and-skill-lifecycle.md)
这些机制让上下文可以被检查、纠正和追溯,但不会自动保证内容为真。开头那次数据库审查是否合格,最后仍要看证据和验收条件。
真实团队不会永远使用同一个模型、IDE 或 Agent。
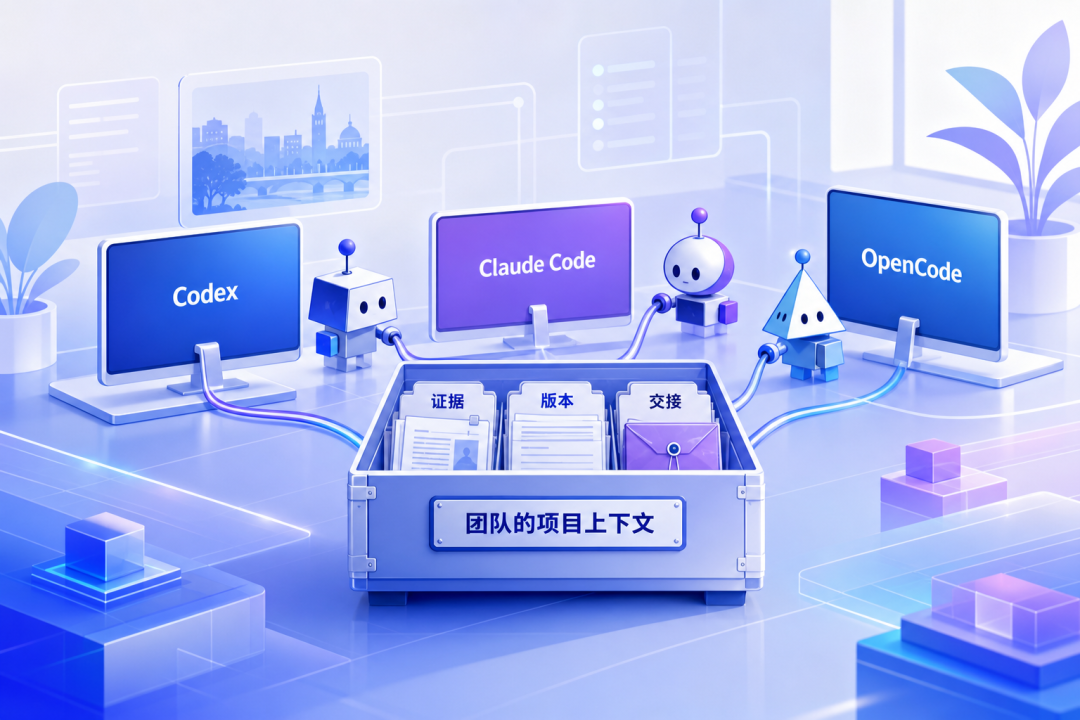
今天在 Codex 里调试,明天可能交给 Claude Code 审查;有人在终端里工作,有人只需要读一份交接报告。如果上下文只存在某个工具的私有历史里,每次切换都要重新搬运。
PowerContext 因此把 Server 作为独立运行层,通过 HTTP/OpenAPI 和 Streamable HTTP MCP 提供能力。项目 Scope、历史修订、来源引用和交接记录由运行层维护,Agent 集成负责在合适的时机采集、召回和呈现。
本地最小启动可使用 SQLite,也可按需配置嵌入式 seekdb 或 OceanBase 后端。仓库提供 Codex、Claude Code、pi 等宿主集成,以及 LangChain、LangGraph 等框架适配;不同入口的能力和成熟度并不相同,不能把他们理解成一组完全等价的插件。
注:安装与存储说明、集成能力矩阵(链接:https://github.com/oceanbase/powercontext/blob/powercontext-v1.0.0/docs/zh/docs/get-started/install-and-run.md)
跨工具接续有一个实际前提:双方必须能访问同一服务中的相关数据,并明确选择同一个 Scope。连接同一个 Server,不代表已经选中同一份项目上下文;换台机器安装插件,也不会自动带走原机器的数据库。
持久化让记录留下来。连接、授权、范围和版本对齐,才让下一位真正用得上。
展示一段顺畅的 Demo,还不足以说明上下文系统有效。
PowerContext 目前公开了两类评测:一类检验长期对话中的问答,一类观察接入后 Coding Agent 的任务结果。
LoCoMo:能否从长对话中找回正确依据
项目评测使用 LoCoMo 的 10 段长对话,其中类别 1—4 共 1,540 道问题计分。公开报告列出的结果如下:
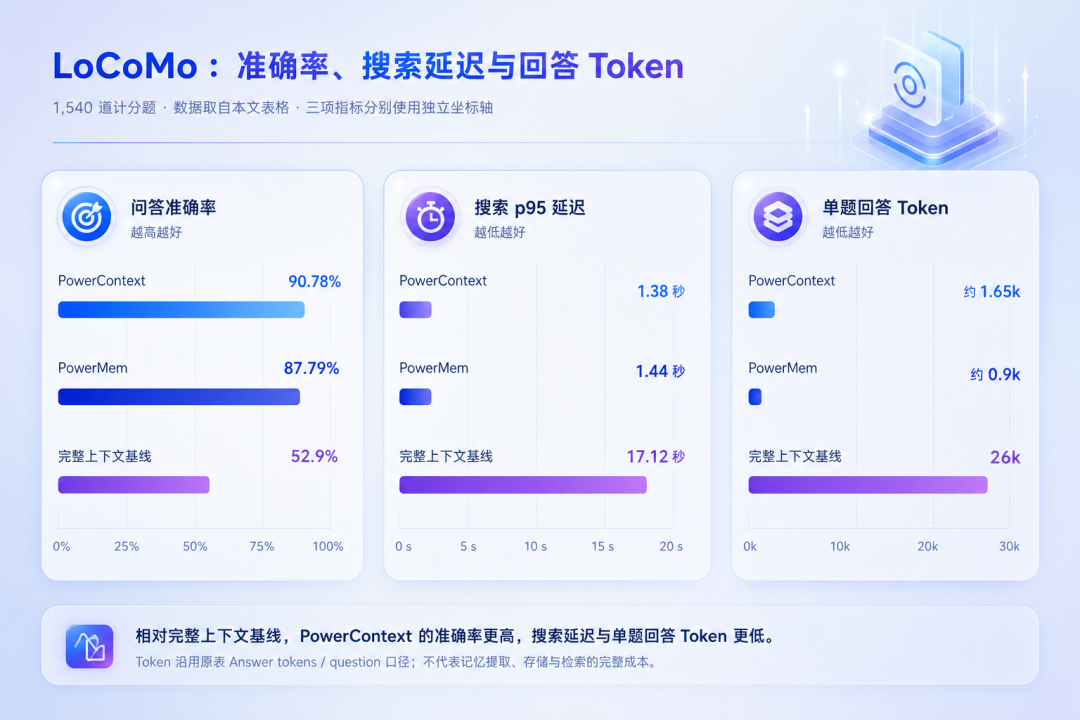
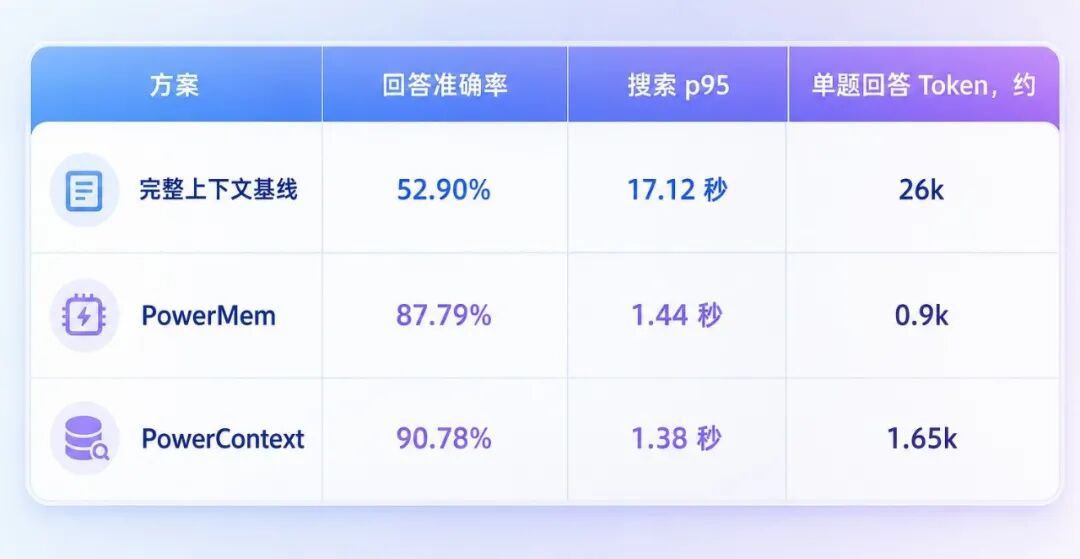
按这组报告的口径,PowerContext 比完整上下文基线高 37.88 个百分点;与 PowerMem 的历史结果相比,高 2.99 个百分点,搜索 p95 略低,但回答 Token 更多。
注:项目评测结果(链接:https://powercontext.oceanbase.io/zh/benchmarks/)
这个代价应该一起看。回答 Token 也不等于整个系统的成本,采集、提取和维护等环节还需要另算。
准确率采用模型裁判,并非独立人工标注。公开结果中的 PowerContext 使用 topical Judge 口径;更换回答模型、裁判策略或检索配置,都可能改变分数,不能据此直接给不同系统排一个通用名次。
注:LoCoMo 评测合同(链接:https://github.com/oceanbase/powercontext/blob/powercontext-v1.0.0/benchmark/locomo/README.md)
SWE-bench Pro:上下文能否帮 Agent 多解决一些任务
项目在 SWE-bench Pro public v2 的 731 个任务上完成了一组 Codex OFF / ON 配对运行。两组使用 gpt-5.6-sol、medium 推理等级,报告中的开关差异是是否启用 PowerContext。
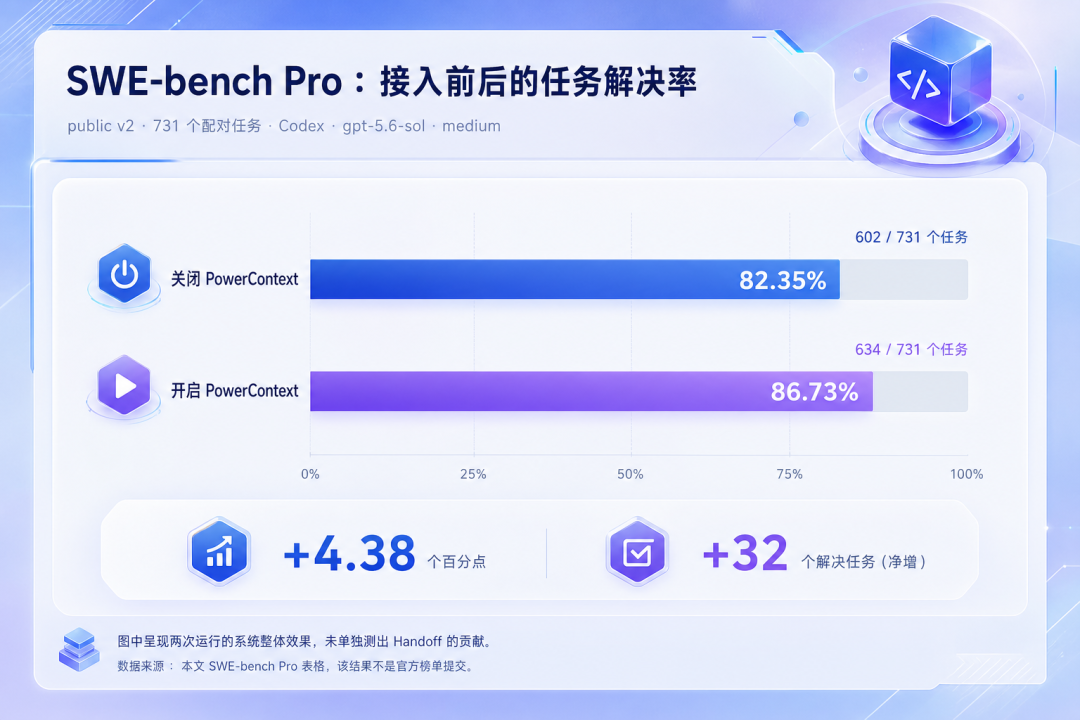
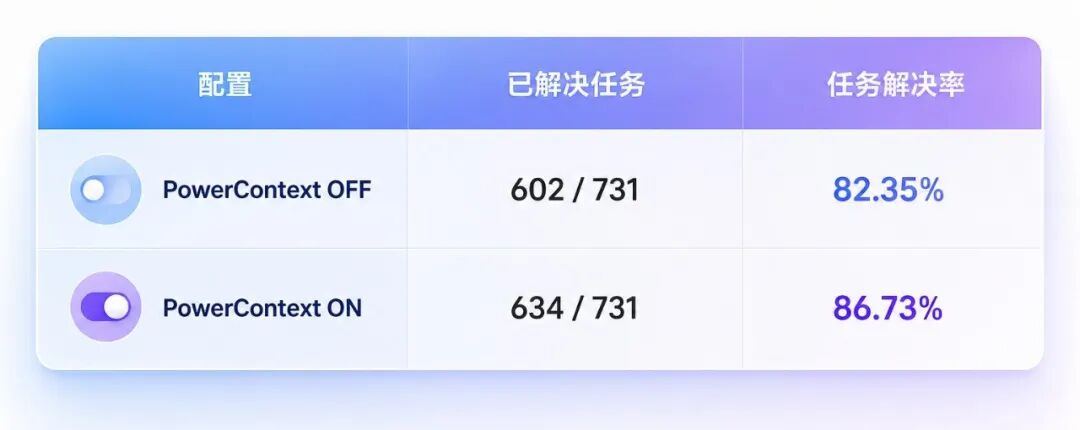
两次运行相差 32 个任务,即 4.38 个百分点。这是固定任务集上的项目实测,不是 SWE-bench Pro 官方榜单提交;Agent 运行存在随机性,结果只描述这组运行。
注:SWE-bench Pro 评测说明(链接:https://powercontext.oceanbase.io/zh/benchmarks/#swe-bench)
这两项测试分别提供了记忆问答和编码任务层面的证据,尚不能直接证明跨角色交接一定更快。开头那类组织协作,还需要测接手耗时、遗漏约束、重复验证和返工次数。
以下以 macOS 或 Linux 上的本机 Codex CLI、PowerContext 1.0.0 为例。先准备 Python 3.11+、Git、uv 和已安装的 Codex CLI。
安装并启动服务:
uv tool install "powercontext[cli,server]==1.0.0"
powercontext server run
在没有自定义配置时,Server 监听 127.0.0.1:8000,使用本地持久化 SQLite。保持这个终端运行。
另开终端,进入要体验的项目,安装匹配版本的集成并检查:
powercontext setup codex --ref powercontext-v1.0.0
powercontext doctor
powercontext doctor codex
codex
确认新会话加载了 PowerContext Hook 和 MCP,并核对 Server 地址、认证配置及 Scope。多个项目需要隔离时,应显式配置 Scope,不能只靠切换目录。完整接入步骤(链接:https://github.com/oceanbase/powercontext/blob/powercontext-v1.0.0/docs/zh/docs/get-started/quickstart.md)
然后做三次验收:
-
保存一条约束。 明确要求把一条后续仍然有效的项目判断保存到 PowerContext,检查保存结果及来源引用。
-
换会话取回。在同一 Scope 的新会话里询问这条判断,检查内容是否正确、引用是否可核对。复述成功不代表结论仍然有效,还要结合当前环境判断。
-
交出未完成的工作。要求使用 PowerContext 交接当前工作,检查实际状态,提交 Handoff,并给出精确版本。把该版本交给接收方,让他先核对代码、证据和权限,再确认是否接手。
doctor 通过只说明相应诊断检查通过,不能代替这三次业务验收。
显式 Memory 操作和手工整理、提交 Handoff,不要求预先配置 PowerContext 服务端的生成模型。自动提取记忆、向量搜索等能力则需要相应的生成和 Embedding 配置。Agent 的订阅登录不会自动为 Server 提供模型 API。
项目上下文会参与 Agent 的判断,也承载团队的工作历史。存了什么、为什么召回、谁改过、如何迁移,这些问题都应该能被检查。
PowerContext 采用 Apache License 2.0 开源,仓库公开运行时、Server、OpenAPI 契约、集成、设计文档和评测工具。团队可以检查这些机制,也可以把自己的失败案例和验收方式补进来。
注:PowerContext 开源仓库(链接:https://github.com/oceanbase/powercontext)
在这里,也想认真感谢每一位参与 PowerMem 与 PowerContext 建设的开源贡献者。代码实现、Agent 集成、测试与评测、文档完善,以及 Issue 里的问题复现和设计讨论,都是这个项目向前推进的每一步。也感谢愿意把他用进真实工作的用户。
接下来,我们计划沿着三个方向继续推进:
-
提高效果:完善采集、检索、使用过程的可观测性,持续跟踪质量、耗时和成本。
-
增强易用性:改进交接与恢复体验,深化宿主集成,完善共享、权限、审计和运维能力。
-
加强可靠性:加强冲突与过期处理,让任务结果和用户反馈进入可验证、可审核的 Experience 与 Skill 演进流程。
这些方向还需要真实工作来检验。一个能复现的失败案例、一份暴露遗漏的交接单,都会帮助我们看清哪里还没做好。
回到周五晚上 9 点 40。理想的下一次交接,新会话应该先知道:哪个方案试过,问题怎样复现,客户有什么约束,哪两项检查还欠着。
他仍然要读代码、跑测试、核对环境;人仍然要对发布做判断。但大家不用再花 20 分钟拼回白天已经知道的事。
Agent 可以换班,但工作不该从头交代。
可以先从手上那件尚未完成的事试起:把他交出去,看看下一位能否说清楚从哪里继续,又该在哪里停下来确认。

立即试用 OceanBase 企业版,体验国产数据库能力立即试用
了解最新的技术洞察和前沿趋势,参与 OceanBase 定期举办的线下活动,与行业开发者互动交流
更多推荐
 0
 0
- 0


 已为社区贡献162条内容

所有评论(0)