基于二维元数据的DevOps 时间序列存储优化实践方案
近日,西安电子科技大学与 OceanBase 团队合作完成的论文《PromTCS: An Efficient Two-Dimensional Metadata Management and Tailored Hybrid Storage Architecture for Performance Monitoring Time Series》被 FAST 2027 接收。
FAST(USENIX Conference on File and Storage Technologies)代表着计算机存储领域的国际最高研究水平。FAST 2027 将于 2027 年 2 月 23 日至 25 日在美国华盛顿州伦顿(Renton)举行。
此次被接收的论文聚焦 DevOps 场景下海量时间序列存储的成本问题。
时间序列存储是 DevOps 性能监控的重要基础,但传统元数据模型按整条时间序列保存标签,难以抑制高基数带来的内存开销,而直接依赖大容量 NVMe SSD 来维持写入性能,又会带来高昂的设备成本。
针对这一问题,PromTCS 提出兼顾性能和成本的存储方案,由二维元数据管理和按介质定制的混合存储架构组成。
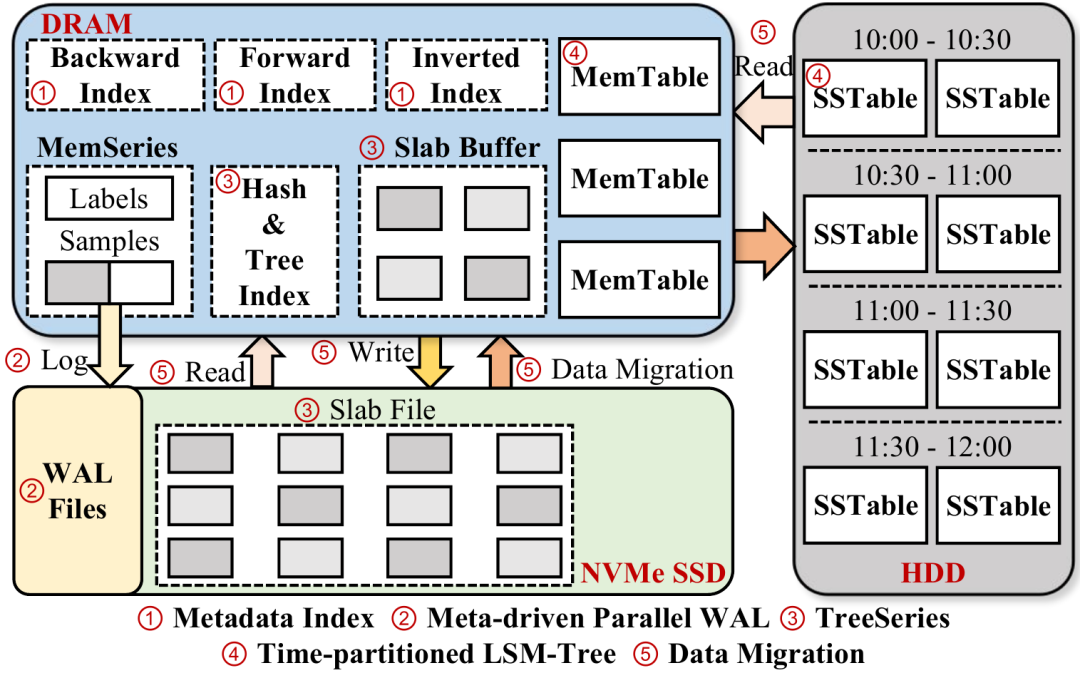
PromTCS 架构图
二维元数据管理
一条性能监控时间序列对应某个数据源上的某个指标。
指标会在大量主机上重复出现,同一数据源又会导出多个指标。PromTCS 据此把标签拆成互不相交的两类:指标标签映射为 MetricID,数据源标签映射为 SourceID,时间序列由 (MetricID, SourceID) 唯一标识。
实验证明,相比 Prometheus tsdb 的原始模型与 TimeUnion 的组模型,二维元数据模型能有效减少内存占用。
在二维模型之上,PromTCS 重新设计了三类元数据索引。
-
后向索引将标签解析为 ID,位于每条读写路径的入口,因而需要支持高并发查找。指标标签与数据源标签分别由一棵 Thmap 管理:读操作无锁,更新使用节点级细粒度锁。
-
前向索引将 (MetricID, SourceID) 映射到时间序列对象。该索引以查询为主,更新仅发生在新序列注册时,因此侧重读性能与存储密度。历史条目存放于可按地址直接访问的扁平数组;新增条目先写入 Thmap,再定期合并进扁平数组。
-
倒排索引将数据源标签映射为 SourceID 的 posting list,采用两级结构。标签 key 基数较小,第一级用 Thmap 管理;标签 value 基数大且仅部分被频繁查询,第二级将热 value 留在 Thmap,冷 value 迁至内存开销更低的 MergeSet,新写入的 value 先进入 Thmap。posting list 存放 SourceID。数据源数量远小于时间序列数量,列表因此更短。
写入路径上,标签划分为指标与数据源两部分,经后向索引得到 MetricID 与 SourceID,再由前向索引定位时间序列对象;新序列则分配 ID 并更新索引。
查询路径上,指标标签经后向索引解析;对数据源标签,在倒排索引上检索 posting list 并求交,再由前向索引取出匹配的时间序列对象。
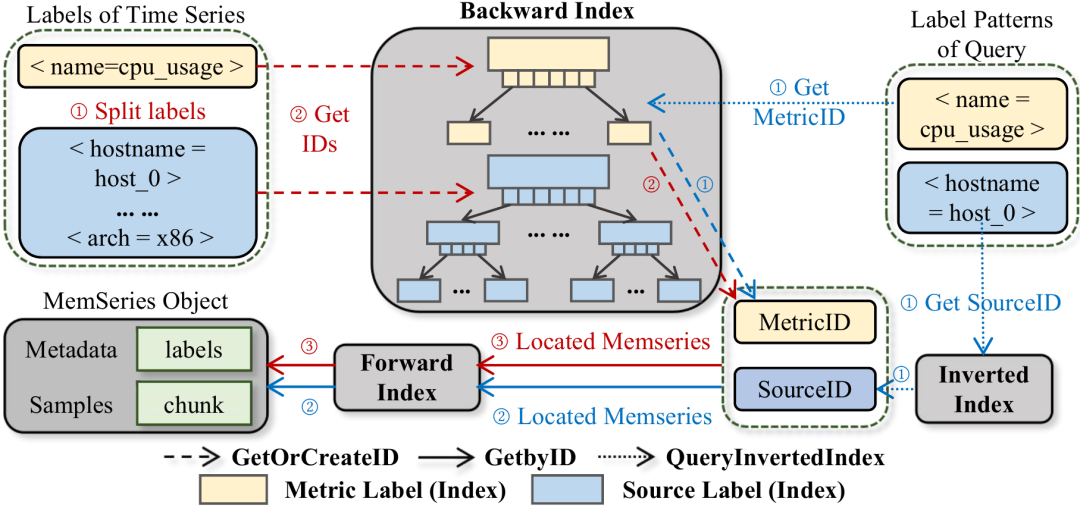
元数据索引读写路径
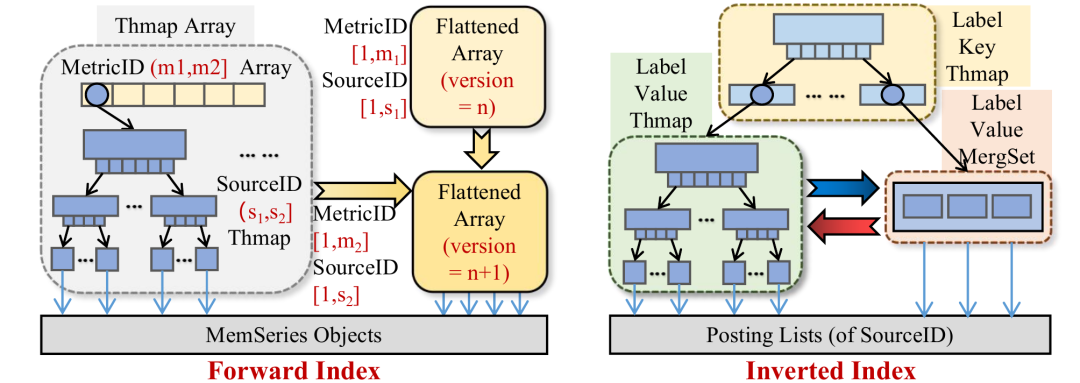
前向索引与倒排索引
为时间序列定制的混合存储架构
混合存储将新数据与日志置于 DRAM 和少量 NVMe SSD,将冷数据置于 HDD。
不同介质的带宽与访问特性各不相同,PromTCS 据此做三处设计:面向 NVMe SSD 的免合并引擎 TreeSeries、按介质区分的数据迁移,以及元数据驱动的并行 WAL。HDD 沿用按时间分区的 LSM-tree 管理冷数据,使合并不与写入和日志争用 SSD 带宽。
TreeSeries
时间分区 LSM-tree 直接部署于 NVMe SSD 时,为维持全局有序而反复合并、重写数据。对照变体在合并期间插入吞吐反复下降,写放大达 5.4 倍。TreeSeries 作为 SSD 上的写缓冲,以宽松有序代替全局排序,从而省去这一合并。
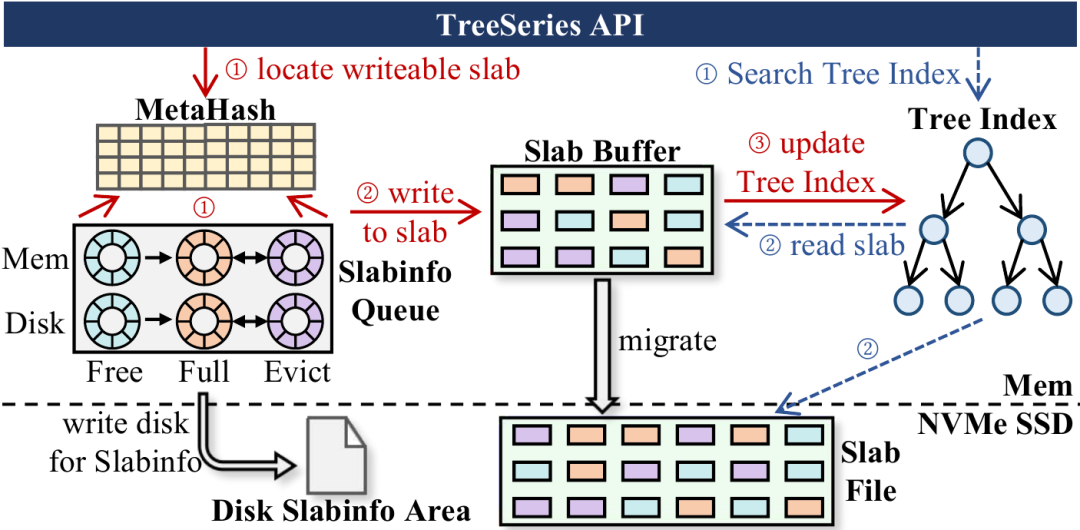
TreeSeries结构
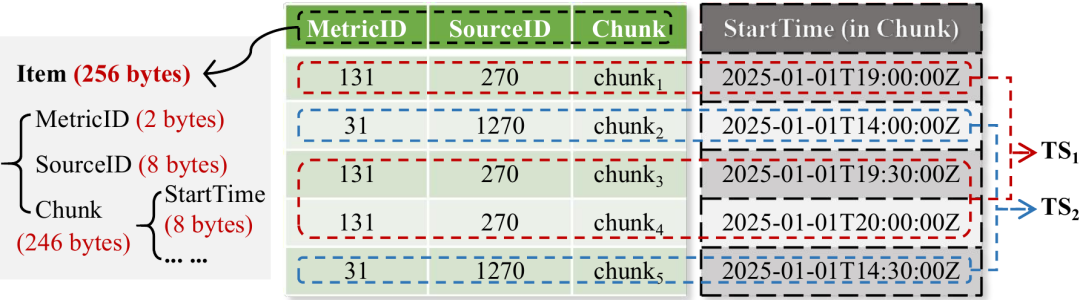
slab结构与宽松有序
数据以与 SSD 页对齐的 4 KB slab 为管理单元,使读写粒度与 SSD 页一致。slab 内 item 的大小在压缩效率与查询时的解压开销之间取折中。写入先进入内存中的 slab buffer,达到阈值后再由后台线程刷入 SSD 上的 slab file,以避免样本直接落盘。
每个 slab 绑定 slabinfo,由无锁队列分别跟踪内存与磁盘上的空闲、已满和待回收状态。已迁出的 slab 进入回收队列,仅当空闲 slab 耗尽时才原地覆盖。
并发由两套索引分担:
MetaHash 是二维表,按 MetricID 与 SourceID 取模定位可写 slab,并以细粒度锁将不同时间序列分散到不同 slab,从而降低插入时的锁争用,也使单个 slab 容纳的时间序列尽量少。
查询使用无锁、缓存友好的 B+ 树,键由同一 slab 内同一时间序列的 SourceID、MetricID 与时间范围组成,以减少索引项和大范围查询的 I/O。
宽松有序指:同一 slab 内、同一时间序列的 item 按起始时间排列;不同时间序列之间,以及不同 slab 之间,不维持顺序。全局有序所需的合并因此可以省去。
宕机恢复只需重建已落盘部分。slab 从 buffer 刷入 SSD 时,系统将已落盘 slab 的 slabinfo 及对应索引项写入 SSD 上的 slabinfo 区域;恢复时读回这些元数据,重建磁盘侧队列与树索引。
在 NVMe SSD 上,相对时间分区 LSM-tree,TreeSeries 的插入吞吐高 6.3–8.2 倍,查询延迟相当,写放大降低 75.8%–81.5%。
数据迁移
DRAM、NVMe SSD 与 HDD 之间的带宽差会使数据堆积在高带宽层,进而限制写入性能。PromTCS 按介质选择写入方式,并以早迁移与懒刷新利用各层 I/O,同时控制对查询的影响。
迁往 NVMe SSD 时,利用其高并发与优于随机写的顺序带宽。已满 slab 的比例达到阈值且 slab file 仍有空间时,后台线程按 SlabID 将相邻 slab 分组:目标地址连续则整组顺序写入,以降低系统调用开销;否则退回按 slab 的并行随机写。
迁往 HDD 时,侧重其远高于随机 I/O 的顺序带宽:顺序读出 slab,按时间序列归组后写入 MemTable,并在本次迁移结束前刷盘,避免 MemTable 在内存中堆积。
早迁移采用较低阈值,使数据提前分布到各层,避免快设备写满后阻塞插入。
懒刷新则推迟回收已迁出的空间:数据仍留在原快设备上供查询使用,直至该空间被新数据覆盖,才更新 TreeSeries 的树索引。关闭懒刷新后,近期查询延迟升高 7.2%–10.9%,长期查询延迟升高 27.4%–31.7%。
相对全量置于 SSD 的 LSM-tree,插入吞吐高 3.37–3.40 倍,SSD 写入量仅为前者的 21.4%–24.8%。相对上层在 SSD、下层在 HDD 的分层 LSM-tree,插入吞吐高 4.69–5.67 倍。SSD 上的合并直接限制插入吞吐;HDD 上的合并只影响迁移,其影响再由早迁移削弱。
元数据驱动的并行 WAL
全局 WAL 在单锁上同步,会限制并发写入;简单地拆成多个 WAL,又引入随机 I/O 与跨组顺序问题。性能监控以追加新样本为主,不同时间序列之间无事务依赖,因而样本日志无需维持全局顺序。
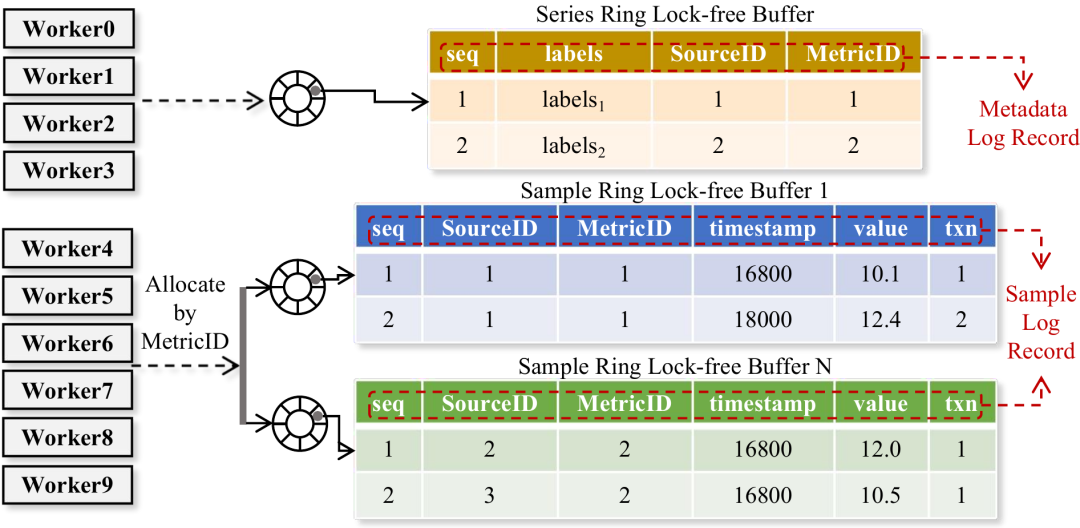
元数据驱动的并行 WAL
PromTCS 将日志分为序列日志与样本日志。
序列日志仅一组,记录时间序列的标签与 ID,供恢复时重建元数据。样本远多于元数据,是写入路径上 I/O 与同步的主要开销,故按 MetricID 取模分至多个日志组(实验中为 5 组,以平衡 CPU 与 I/O)。
每组拥有独立的内存环形缓冲区、磁盘目录与组提交线程,组间互不阻塞,也无需跨组保序。
分组键取 MetricID,使同一指标的样本聚集;同一指标的数值更接近,压缩效率更高。相对按 MetricID 与 SourceID 分组,真实数据上压缩效率最高提升 36.2%。
可靠性按时间序列校验:chunk 写入 TreeSeries 之前,以单调递增的样本序号确认其中最后一条日志已经落盘。
样本持久化到 SSD 后,对应样本日志即可清理;序列日志体积小,且恢复时需要,故予以保留。
宕机恢复时,先由序列日志重建元数据索引,再按日志目录并行重放。各目录中的时间序列互不依赖,重放无需同步。
TreeSeries 与 HDD 上的 LSM-tree 只读取少量元数据,开销远小于日志重放。相对 Prometheus tsdb 的全局 WAL,插入吞吐提高 42.7%–69.7%。

立即试用 OceanBase 企业版,体验国产数据库能力180 天免费试用,零门槛开通
了解最新的技术洞察和前沿趋势,参与 OceanBase 定期举办的线下活动,与行业开发者互动交流
更多推荐
 0
 0
- 0


 已为社区贡献167条内容

所有评论(0)